Claude schreibt schlechter für Menschen: Warum das eine Warnung für dein Wissenssystem ist
Ein Anthropic-Mitarbeiter zeigt, wie Claude beim Feintuning an menschlicher Schreibweise verliert. Das ist ein Weckruf für jedes Wissenssystem, das blind auf ein KI-Modell vertraut, statt eigene Qualitätskontrolle einzubauen.
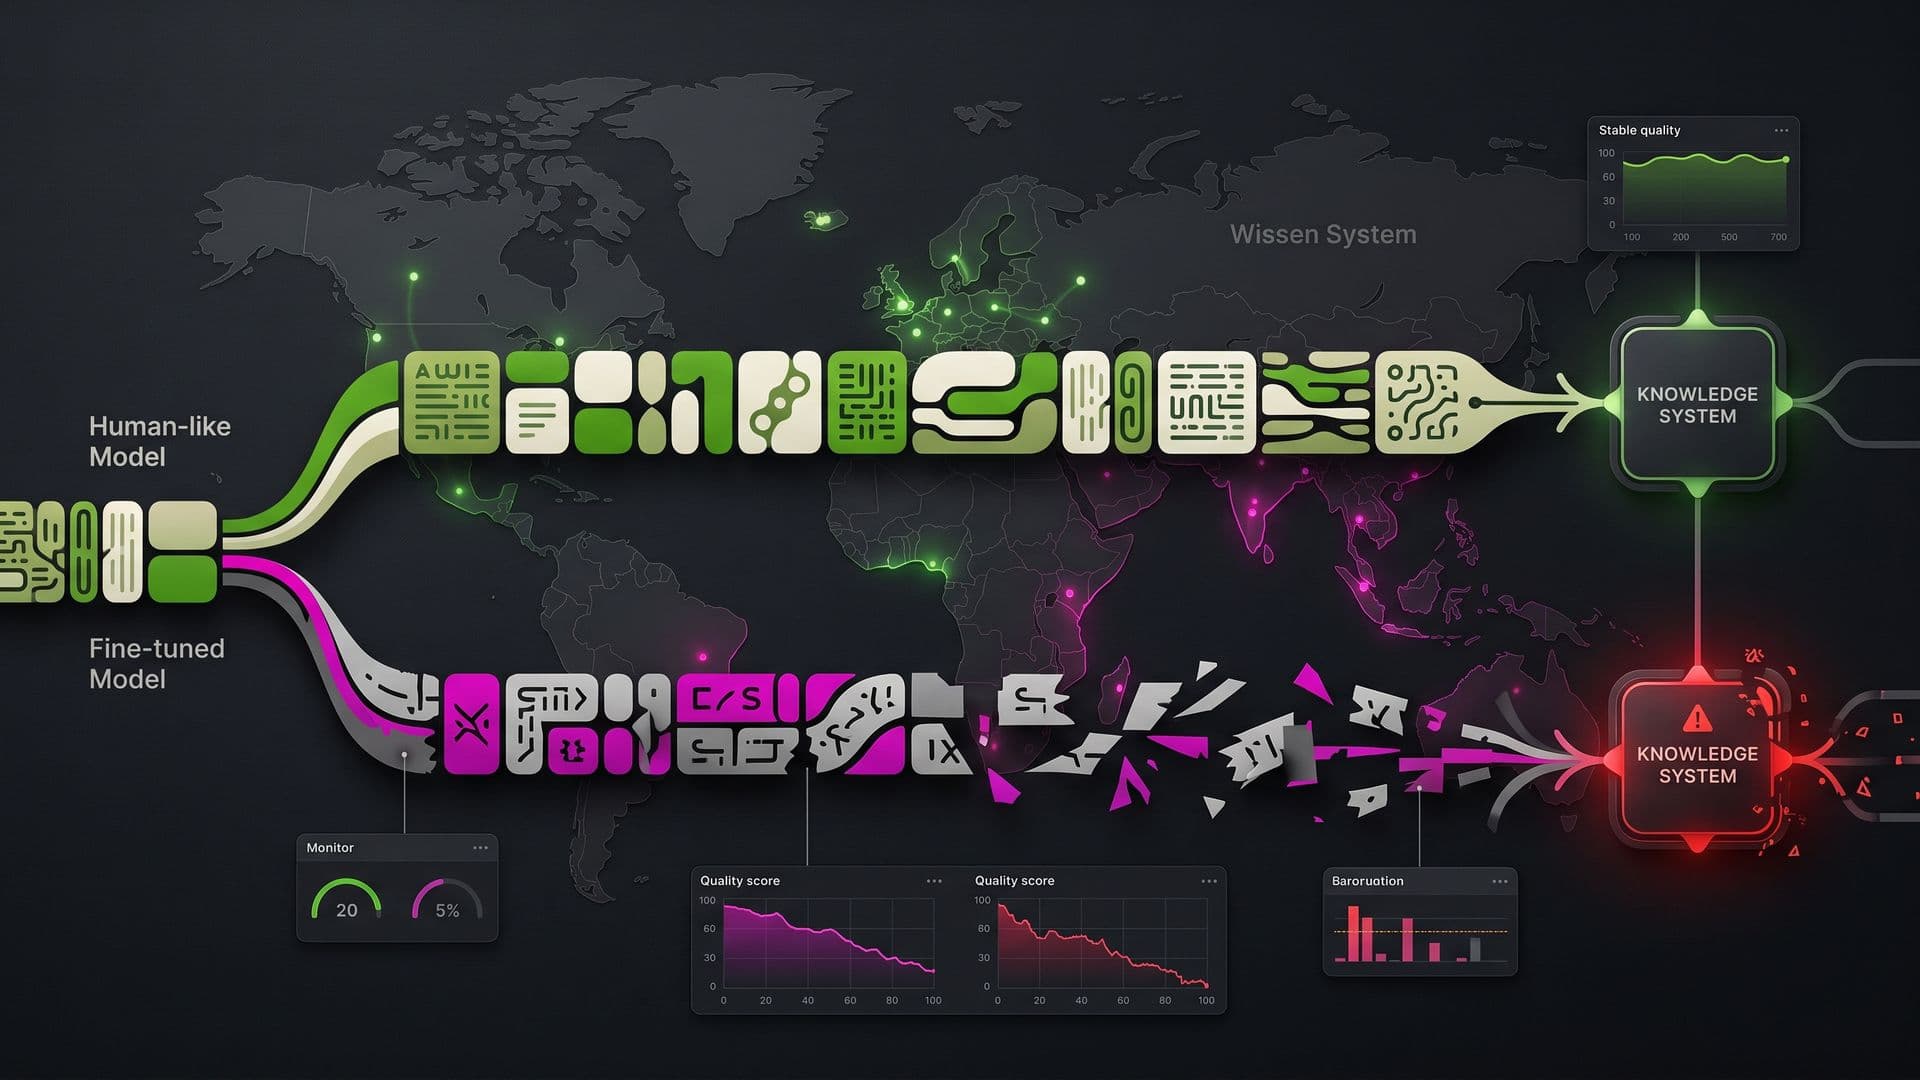
Ein Mitarbeiter von Anthropic hat kürzlich öffentlich beschrieben, wie das Modell Claude beim Feintuning einen Teil seiner natürlichen, menschenähnlichen Schreibweise verliert. Für dich als Unternehmer ist das mehr als eine technische Randnotiz. Es ist ein Warnsignal: Wer sich blind auf ein KI-Modell verlässt, ohne eigene Qualitätskontrolle im Wissenssystem, riskiert schlechtere Ergebnisse, ohne es zu merken.
Was genau ist passiert?
Anthropic trainiert seine Modelle in mehreren Schritten. Zuerst lernt das Modell aus riesigen Textmengen, wie Sprache grundsätzlich funktioniert. Das nennt man Pretraining. Danach folgt das Feintuning (das ist die gezielte Nachschulung auf bestimmte Aufgaben, zum Beispiel hilfreiche Antworten geben oder bestimmte Regeln einhalten). Genau in diesem zweiten Schritt hat der Mitarbeiter beobachtet, dass Claude anfängt, unnatürlicher zu klingen. Sätze werden steifer, Formulierungen wirken generischer, der Text verliert an menschlichem Flair.
Das passiert nicht, weil die Entwickler das wollen. Es ist ein Nebeneffekt davon, dass Modelle beim Feintuning auf bestimmte Muster optimiert werden, etwa auf Sicherheit, Höflichkeit oder Konsistenz. Dabei geht manchmal die sprachliche Feinheit verloren, die einen Text lebendig und glaubwürdig macht.
Warum das für dein Unternehmen wichtig ist
Vielleicht denkst du jetzt: Das ist ein Problem von Anthropic, nicht von mir. Aber genau hier liegt der Denkfehler. Wenn du ein KI-gestütztes Wissenssystem in deinem Unternehmen einsetzt, egal ob für Kundenanfragen, interne Dokumentation oder automatisierte Angebote, nutzt du meistens ein fertiges Sprachmodell wie Claude, GPT oder ein anderes. Du hast keinen Einblick, wie dieses Modell im Hintergrund trainiert oder verändert wurde.
Das bedeutet: Die Qualität deiner KI-Ausgaben hängt von Entscheidungen ab, die andere getroffen haben, oft ohne dass du davon erfährst. Ein Modell-Update kann plötzlich dazu führen, dass deine automatisch generierten Texte holpriger klingen, dass wichtige Nuancen fehlen oder dass Antworten technisch korrekt, aber menschlich unpassend wirken.
Stell dir vor, du betreibst ein Maklerbüro in Kärnten und nutzt ein KI-System, das automatisch Exposé-Texte oder Antworten auf Kundenanfragen formuliert. Wenn das zugrunde liegende Modell nach einem Update plötzlich steifer oder unpersönlicher klingt, wirkt sich das direkt auf deine Kunden aus. Niemand merkt sofort, warum die Texte weniger überzeugend sind. Man merkt nur, dass weniger Anfragen zu Terminen führen.
Praxisbeispiel: Der stille Qualitätsverlust
Nehmen wir ein realistisches Szenario. Ein mittelständisches Hotel in Kärnten nutzt ein KI-System, um automatisch auf Gästebewertungen zu antworten und individuelle Angebote per E-Mail zu verschicken. Die Texte werden direkt vom Sprachmodell generiert, ohne dass jemand im Team sie vorher liest oder anpasst.
Drei Monate nach einem Modell-Update fällt auf, dass die Buchungsrate über die automatisierten Angebote leicht gesunken ist. Bei einer Überprüfung zeigt sich: Die Texte klingen technisch korrekt, aber unpersönlich. Formulierungen wie „Wir freuen uns, Ihnen mitteilen zu können, dass wir Ihre Anfrage bearbeitet haben“ ersetzen frühere, wärmere Sätze wie „Schön, dass Sie bei uns anfragen. Wir haben genau das richtige Zimmer für Sie.“ Niemand im Team hatte das bewusst geändert. Das Modell im Hintergrund hatte sich einfach verändert.
Der Schaden lässt sich beziffern: Bei rund 40 automatisierten Angeboten pro Monat und einer Buchungsquote, die von 18 auf 14 Prozent gesunken ist, verliert das Hotel etwa zwei bis drei Buchungen monatlich. Bei einem durchschnittlichen Zimmerpreis von 140 Euro pro Nacht und einer typischen Aufenthaltsdauer von drei Nächten sind das schnell über 1.000 Euro entgangener Umsatz pro Monat, nur weil niemand die Texte stichprobenartig geprüft hat.